Qué es TypeSafe
TypeSafe AI es un laboratorio que nació de una pregunta incómoda: los modelos son sobrehumanos a la hora de chatear desde hace años, ¿entonces dónde está toda la automatización que prometen? La respuesta que construyeron es una nueva clase de modelo que no genera texto para personas, sino decisiones tipadas para software.
La idea central
Los modelos que usamos hoy fueron entrenados con RLHF para optimizar las preferencias humanas. Eso los hizo brillantes conversando, pero también poco confiables para correr solos en un proceso: son sobreconfiados, sufren mode dropping y pueden alucinar. El resultado es que siempre hace falta un humano en el loop.
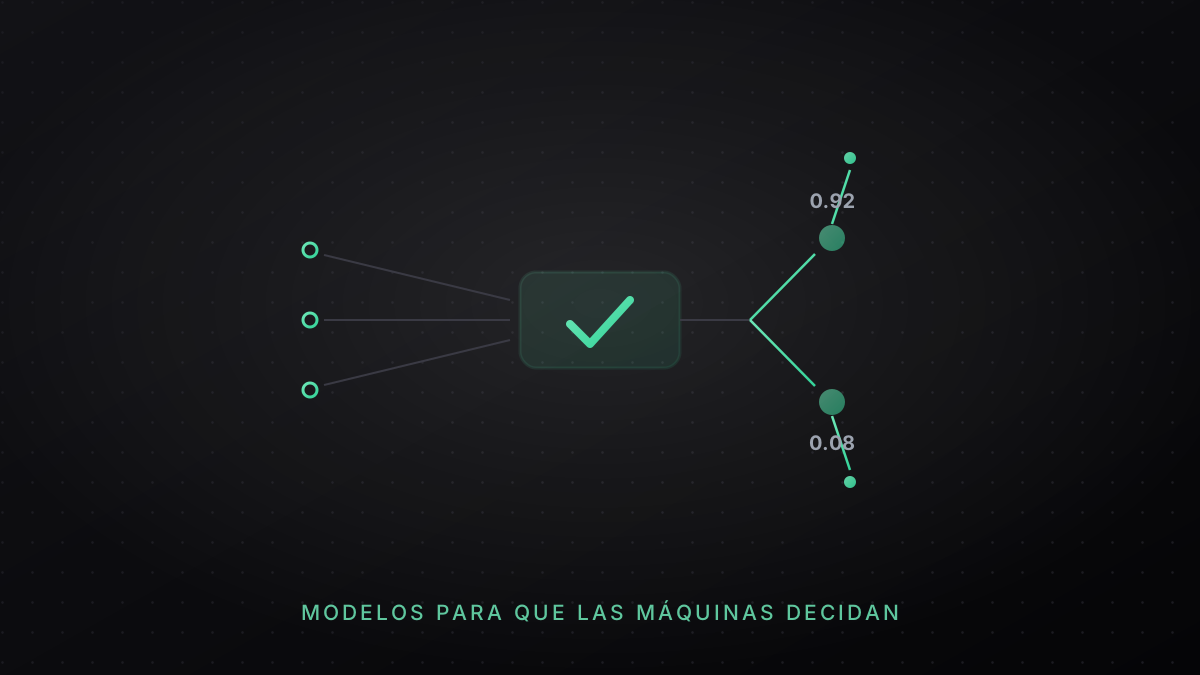
La apuesta de TypeSafe es casi el espejo: en vez de optimizar para que una persona lea, optimizan para que una máquina consuma. Los System One Models toman un estado estructurado y devuelven valores tipados, con una probabilidad de confianza calibrada por cada decisión.
Cómo está construido
Todo se apoya en tres piezas nuevas:
- Arquitectura de modelo nueva: pensada para salida estructurada, no para generar strings.
- Sampler paralelo: en vez de generar de a un token, produce todas las salidas en una sola pasada. Por eso responden en 70–500 ms mientras los LLM de la frontera tardan de 3 a 329 segundos.
- Entrenamiento RLCD (Reinforcement Learning for Calibrated Decisions): en vez de optimizar preferencias, optimiza decisiones con probabilidades honestas desde el punto de vista epistémico.
Jev es el primer modelo público de esta clase, ya en early access.
Por qué es importante
Si un modelo puede hacer una tarea el 95 % de las veces pero no te dice cuándo está en ese 5 %, es imposible automatizarla de verdad. Jev acompaña cada decisión con una estimación de confianza: el software actúa solo cuando la confianza es alta y escala a un humano cuando no. Es la base de los smart if-statements — clasificar, rutear, puntuar, extraer o ramificar donde la lógica escrita a mano es demasiado frágil.
Los números que muestran son contundentes: 193,6x más rápido y 444,6x más barato que los LLM comparados en las mismas workflows. Eso sí: son evals pensados para tareas System One, el caso de uso fuerte de Jev, así que son el extremo alto de la mejora real.
Siguiente paso
Jev está en early access: podés entrar a la waitlist, probarlo en la consola y leer las docs. Si querés el detalle técnico, el post de lanzamiento desglosa la comparación modelo por modelo, los workflow evals y los demos (Doom y wikiracing).