Qué es
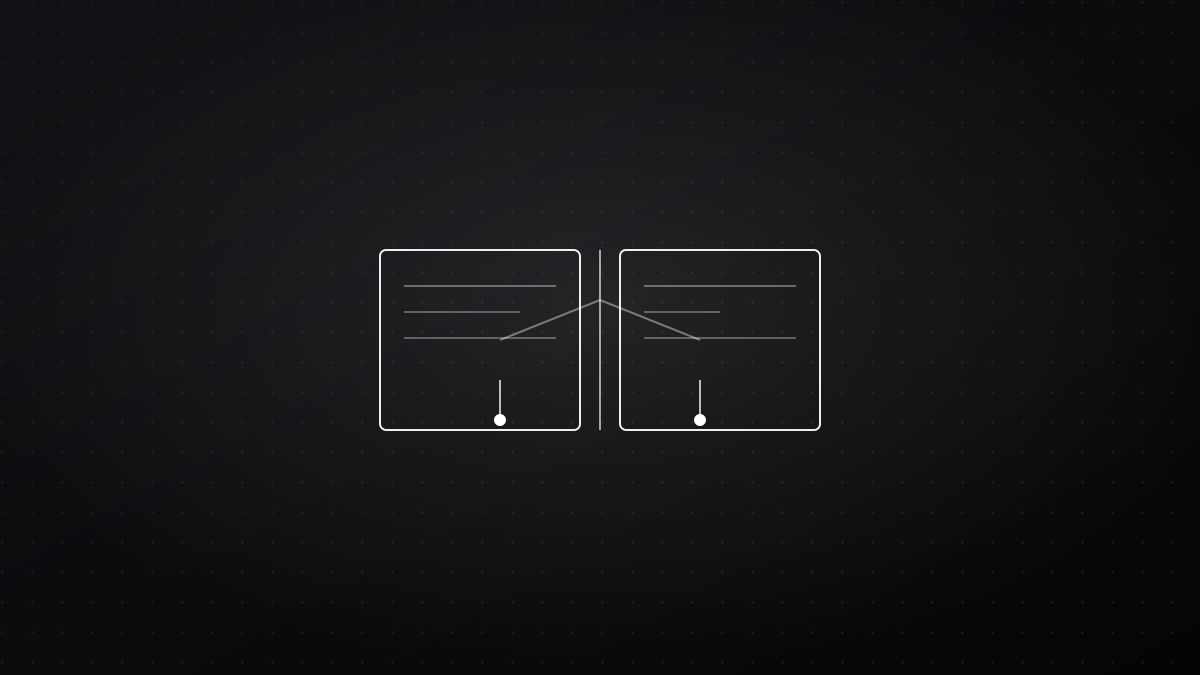
Arena (antes LMSYS Chatbot Arena, rebautizada en enero de 2026) es la plataforma de evaluación de modelos de IA más influyente del mundo, disponible en arena.ai. Su método es tan simple que parece una broma, y por eso mismo funciona: vos ves dos respuestas anónimas generadas por dos modelos distintos, y votás cuál te gusta más.
Ese voto alimenta un ranking tipo Elo (el sistema de los ajedrecistas) que se volvió la referencia que mira toda la industria para saber cuál modelo es “mejor”. Más de 11 millones de votos humanos y casi 400 modelos rankeados la convierten en la medida de calidad más honesta que existe: no la que le conviene al marketing de una empresa, sino la que construyen las personas de verdad, voto a voto.
La idea central: los benchmarks mienten, el voto humano no
Los benchmarks académicos (MMLU, HumanEval) miden tareas de laboratorio que los modelos pueden “entrenar” para pasar. Arena mide algo más profundo: lo que la gente realmente prefiere. Y la diferencia es enorme:
- Un benchmark dice “este modelo sacó 92 en tal test”.
- Arena dice “la gente, a ciegas, elige este modelo 60% de las veces contra el otro”.
¿Qué importa más? Para el uso real, la segunda. Por eso se usa el sistema Elo con el modelo estadístico Bradley-Terry: cada votante compara dos respuestas a ciegas (no sabe qué modelo generó cada una), y el resultado alimenta los puntajes.
modelo A vs modelo B (anónimos) → votás → se actualizan los Elo → ranking en vivoCómo funciona por dentro
Las Arenas
Arena no rankea “todo” con una sola medida. Tiene arenas por categoría:
- Text Arena: el ranking general, con sub-categorías de Coding, Math, Creative Writing, Instruction Following, Hard Prompts, Expert y Longer Query.
- Coding Arena: votos limitados a tareas de código. Acá el ranking cambia respecto al general: los thinking de Anthropic mandan.
- Agent Arena (lanzada el 4 de junio de 2026): la más nueva y la más interesante. En vez de votar qué respuesta suena mejor, mide si el modelo completa tareas agénticas reales: usa herramientas (bash, archivos, web search), escribe código, se recupera de errores. Está armada con millones de sesiones reales de Agent Mode y rastreo causal: la medición más honesta de “esta IA sirve para laburar de verdad”.
Los números que ves
Cada modelo muestra su Elo con un margen de error (los votos no son infinitos), su precio por millón de tokens y el contexto. Los que tienen pocos votos salen marcados como “Preliminary”, porque con poca muestra el puntaje no es confiable.
La foto del podio (agosto 2026)
La foto cambia semana a semana — verificá los puntajes en vivo en arena.ai/leaderboard — pero en agosto de 2026 el panorama es:
- Text Arena: domina Anthropic. Claude Fable 5 lidera (~1506 Elo), seguido de cerca por las variantes thinking de Claude Opus 4.6/4.7/5 y GPT-5.6. Dato de color: Fable 5 fue suspendido temporalmente en junio por una orden de control de exportaciones de EE.UU. y volvió el 1 de julio… directo a la punta.
- Open weights: Qwen 3.8 Max es el modelo abierto mejor rankeado (~1490, top 10 global), con Kimi K3 (Max) y Qwen 3.7 Max pisándole los talones. La brecha con los cerrados se achicó muchísimo en medio año.
- Coding: los thinking de Claude lideran el Coding Arena.
- Agent Arena: en el snapshot de lanzamiento lideró GPT-5.5 (High) con Claude Opus 4.7 (Thinking) segundo; en la foto actual manda Claude Opus 5 (Max). Cambia rápido porque es la medición más joven.
Por qué es importante
- Es la fuente de verdad de la industria: cuando un modelo “gana”, se cita a Arena. Lanzamientos enteros se validan (o se pinchan) con estos votos. No es un blog de opinión: son datos de millones de personas.
- Vos podés participar: la evaluación más importante del mundo la construyen usuarios comunes. Entrás, comparás dos respuestas, votás, y tu voto cuenta de verdad.
- Mide lo que importa, no lo que conviene: los benchmarks son manipulables; el gusto humano, mucho menos. Y con Agent Arena, la medición saltó de “qué lindo que suena” a “si completa el laburo”.
- Expone el avance del open source: ver modelos abiertos escalar posiciones mes a mes es el termómetro más claro de que la IA abierta le está ganando la partida a la cerrada en calidad por dólar.
Siguiente paso
Entrá a arena.ai, andá al Text Arena y votá unas cuantas comparaciones ciegas: te muestran dos respuestas a un mismo prompt y vos elegís cuál preferís. Después mirá cómo cambia el ranking en vivo con los votos que acabás de sumar. La próxima vez que alguien te diga “este modelo es el mejor”, preguntale si lo dice el marketing… o la Arena.
Sitio oficial: arena.ai — leaderboard: arena.ai/leaderboard — blog: blog.arena.ai