Qué es
El mundo de los agentes de IA de código abierto se ve distinto en 2026. Dejó de ser un debate de nicho: hoy la pregunta no es solo qué agente usás, sino qué modelo le ponés por debajo y dónde lo corre.
Contabo publicó un análisis comparativo de los tres pesos pesados y la línea de modelos Hermes. Te lo resumo acá con el criterio que importa para decidir.
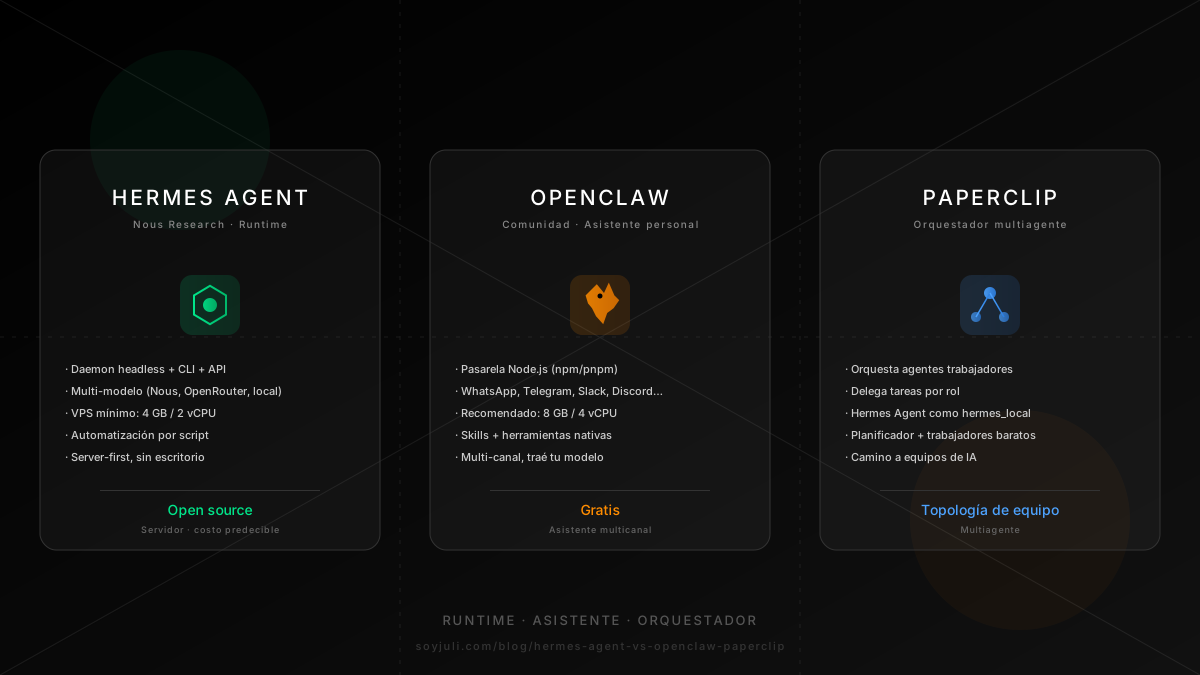
Los tres agentes de 2026, en un panorama
Hermes Agent (de Nous Research) es un entorno de ejecución open source, liviano, configurable por script, pensado para correr como un servicio headless en un VPS. No está atado a un solo modelo: soporta Nous Portal, OpenRouter, OpenAI, NovitaAI, NVIDIA NIM, Hugging Face y endpoints locales.
OpenClaw es, en cambio, una pasarela de asistente personal en Node.js. En vez de apuntar al servidor, apunta a los canales de mensajería: WhatsApp, Telegram, Slack, Discord, iMessage, Signal, Teams y Matrix, con skills y uso de herramientas integrados de forma nativa.
Paperclip AI juega en otra capa: es un orquestador multiagente. No labura "solo" como un agente, sino que coordina agentes trabajadores. Y acá viene lo bueno: Hermes Agent incluye un adaptador oficial (hermes_local) para registrarse como empleado gestionado dentro de una organización Paperclip.
Hermes Agent vs OpenClaw: la comparativa
La respuesta corta: Hermes Agent está optimizado para minimizar consumo de recursos en el servidor (automatización por script), mientras que OpenClaw está optimizado para ser un asistente personal multicanal. En seis dimensiones clave:
| Dimensión | Hermes Agent | OpenClaw |
|---|---|---|
| Forma principal | Daemon headless + CLI + API HTTP (puerto 8642) | Pasarela Node.js (npm/pnpm/bun) |
| Modelo por defecto | Multi-proveedor (Nous, OpenRouter, OpenAI, local…) | Traé tu propio (Anthropic/OpenAI/local) |
| Ecosistema | Herramientas de código menores | Skills + adaptadores de canal (WhatsApp, Slack…) |
| VPS mínimo | 4 GB RAM / 2 vCPU (modelos chicos) | 8 GB RAM / 4 vCPU recomendados |
| GPU | Opcional (7B-13B), requerido (70B+) | Opcional, según backend |
| Licencia | Open source | Open source |
Cuándo elegir Hermes Agent
- La implementación es server-first: accedés por SSH o HTTP, sin escritorio.
- Querés un proceso liviano que se integre limpio con Hermes 3 o Hermes 4 sin adaptadores extra.
- Tu cadena de herramientas es código: n8n, cron, scripts de shell o tu propio backend.
- Necesitás ajustarte a 4-8 GB de RAM en un VPS barato.
- Querés un camino de actualización simple entre versiones de modelo Hermes.
Cuándo elegir OpenClaw
- Querés un asistente accesible desde WhatsApp, Telegram, Slack, Discord, iMessage, Signal, Teams o Matrix.
- Querés una base Node.js que ampliás con skills propias.
- El despliegue es una estación de trabajo o un servidor personal, no producción a gran escala.
- Planeás combinar Anthropic, OpenAI y modelos locales detrás de un solo asistente.
Hermes Agent vs Paperclip: ¿agente único o equipo?
No es un duelo directo. Paperclip es el orquestador, Hermes Agent es el trabajador, y se componen vía el adaptador oficial hermes-paperclip-adapter.
Usá Hermes Agent solo cuando un único proceso bien diseñado alcance: triage de bandeja de entrada, un bot de review de código o un asistente de soporte. Usá Paperclip cuando necesites varios agentes especializados que se pasen el laburo, cada uno con su prompt y sus herramientas.
En una topología Paperclip, Hermes Agent se registra como trabajador hermes_local — normalmente el empleado barato y rápido detrás de uno o varios roles, mientras un modelo más grande se reserva para la planificación. La pregunta correcta rara vez es "¿Hermes Agent o Paperclip?", sino "¿esto es tarea de un agente solo o de un equipo?"
Otras alternativas que vale la pena conocer
Si ninguno de los tres encaja, aparecen otros nombres:
- LangGraph — flujos de agentes en Python con forma de grafo y estado persistente. Curva más pronunciada.
- AutoGen — patrones de conversación multiagente con juego de roles. Modelo conversacional todavía en maduración.
- CrewAI — pequeños equipos de agentes por roles. Menos flexible para workflows complejos no lineales que LangGraph.
La elección depende de si querés una librería, un runtime o un orquestador.
Hermes 3 vs Hermes 4: el modelo importa tanto como el runtime
La decisión del modelo está por debajo de todas las demás: un runtime excelente no compensa un modelo insuficiente, y uno sobredimensionado te quema el presupuesto del VPS.
Hermes 3 es más antiguo, más amplio y se distribuye en 3B, 8B, 70B y 405B — todos fine-tune sobre Llama 3.1/3.2. Incluye variantes sin censura para investigación.
Hermes 4 (lanzado el 26 de agosto de 2025) viene en 70B y 405B y agrega razonamiento en modo híbrido. Actualizás cuando tu cuello de botella sea la calidad de respuesta, no el costo de infraestructura. Mantené Hermes 3 si estás limitado por RAM/VRAM o necesitás los tamaños 3B/8B.
| Modelo | ¿Solo CPU factible? | Mejor para |
|---|---|---|
| Hermes 3 3B | Sí | Chat VPS de bajo costo |
| Hermes 3 8B | Sí, lento | Chat barato + uso de herramientas |
| Hermes 3 / 4 70B | No | Razonamiento de calidad en GPU |
| Hermes 3 / 4 405B | No | Investigación multi-GPU |
Matriz de decisión en 60 segundos
| Caso de uso | Agente | Modelo |
|---|---|---|
| Bot en un solo VPS | Hermes Agent | Hermes 3 3B u 8B |
| Asistente en canales de mensajería | OpenClaw | Claude/OpenAI, o Hermes 3 8B local |
| Pipeline de contenido multi-agente | Paperclip orquestando Hermes Agent | Planificador Hermes 4 70B + trabajadores 8B |
| Razonamiento de alta calidad en GPU | Hermes Agent | Hermes 4 70B o Hermes 3 70B |
Siguiente paso
Si te copó el tema, el análisis completo está en el blog de Contabo con tablas detalladas de VRAM y los pasos para auto-alojar Hermes Agent en un VPS. También podés mirar los proyectos de Hermes Agent y OpenClaw acá en el sitio.
Publicado el 30 de agosto de 2026 · JX